
Problema
Comparar modelos que reconocen dígitos manuscritos y examinar en qué clases se concentran los errores.
Solución
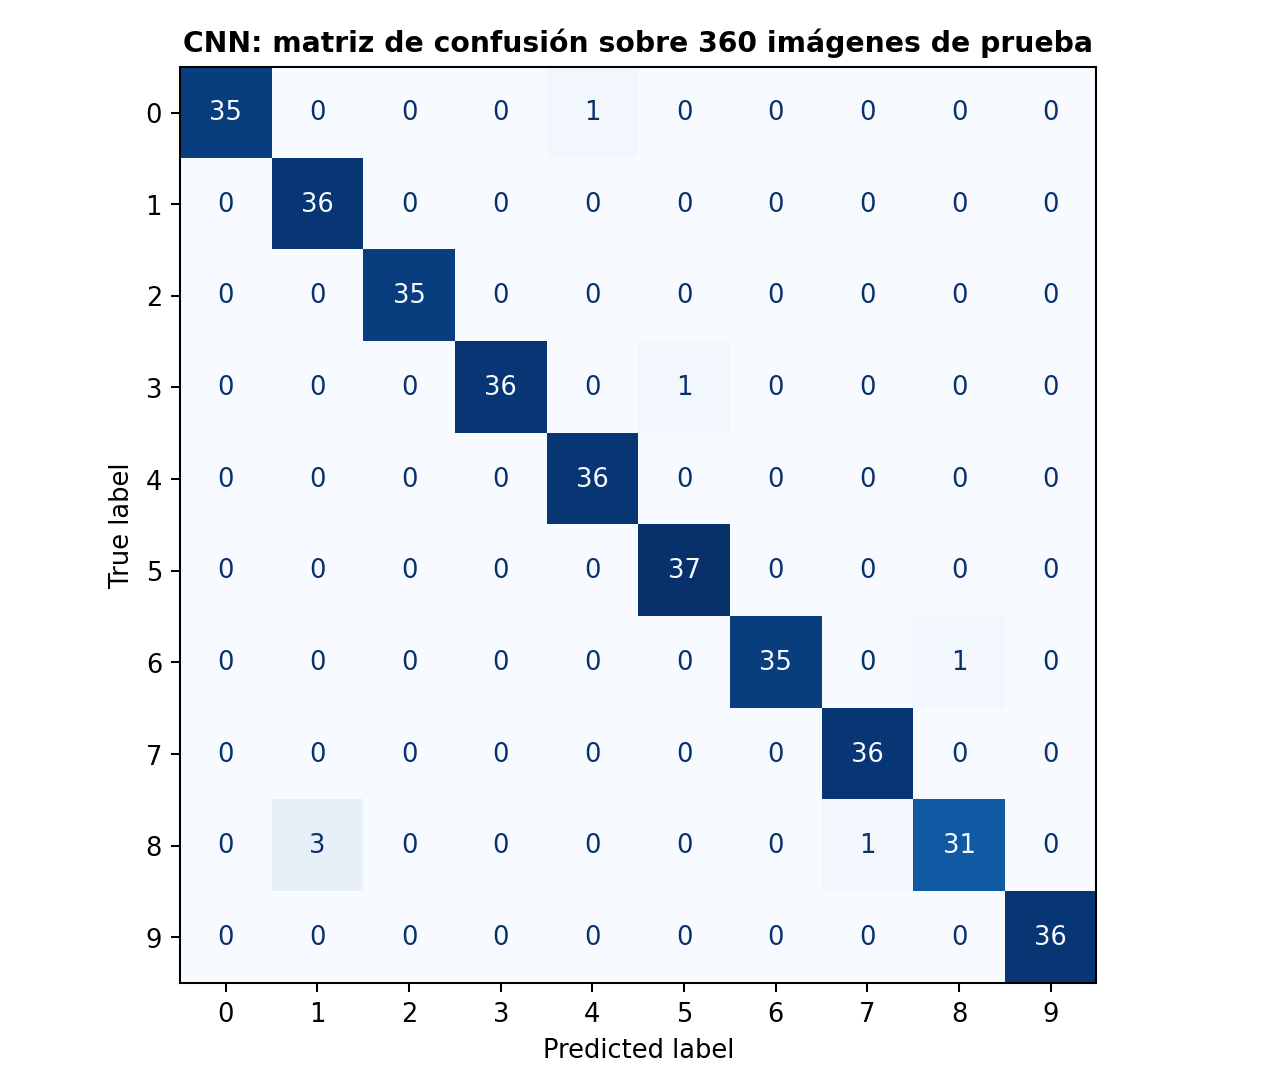
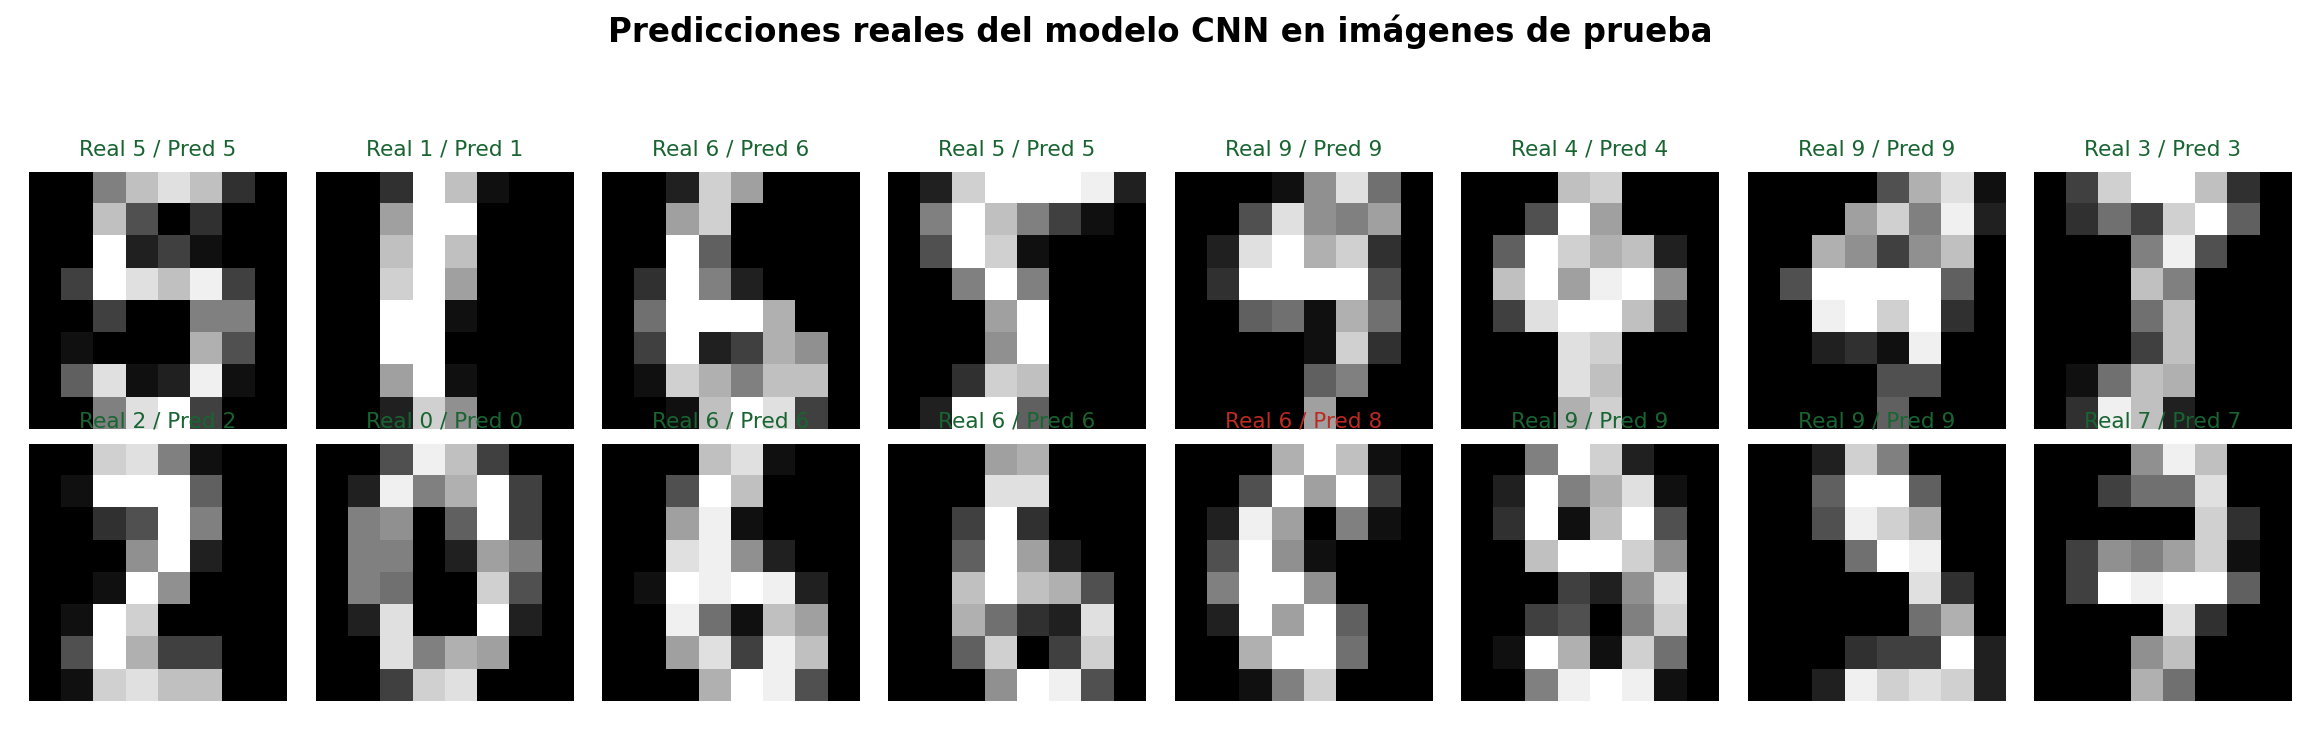
El trabajo compara una red convolucional, KNN y regresión logística con Digits de scikit-learn. Se normalizaron 1 797 imágenes de 8 × 8 y se reservó un conjunto de prueba de 360 imágenes.
Mi participación
El informe de SENATI registra mi trabajo de preparación de datos, comparación de modelos y evaluación del prototipo.
Arquitectura técnica
- Imágenes de Digits
- Preparación de datos
- CNN, KNN y regresión logística
- Predicciones y evaluación
Funcionalidades
- Comparación de tres enfoques de clasificación.
- Evaluación con métricas y matrices de confusión.
Decisiones técnicas
La tasa de aprendizaje de la CNN se eligió mediante validación estratificada de tres pliegues en el conjunto de entrenamiento.
Evidencias
Exactitud sobre las mismas 360 imágenes de prueba. Son resultados del informe de SENATI y corresponden a dígitos aislados de Digits.
- KNN (k = 3)
- 98,61 %
- CNN
- 98,06 %
- Regresión logística
- 97,22 %
Aprendizajes
KNN obtuvo la mayor exactitud en esta prueba. La evaluación usó imágenes de dígitos aislados. Para aplicar el método a formularios físicos todavía haría falta probar el recorte de dígitos, la calidad de las fotografías y la revisión de predicciones dudosas.